許多賣家在改商品頁時,習慣用「我覺得這張主圖比較清楚」「這句文案好像更有力」來決定方向——但感覺說不清楚究竟是對是錯。A/B測試提供了一條更穩的道路:一次只改一個變因,把兩到三個版本同時放給真實訪客,用收單數據證明哪個版本勝出。本文帶你用5個步驟走完一場嚴謹的電商A/B測試,從假設、樣本數、實驗設計到統計顯著性的判讀一次搞懂,並以文案、圖片與價格三個最常測的項目作為實例。全程用繁體中文、站在台灣賣家的營運情境,即使沒有程式背景也能照做。
一、為什麼電商需要A/B測試?
電商經營最貴的,往往不是廣告費,而是「改了卻不知道改對沒有」的隱形成本。你可能花了一整週重寫商品頁文案,結果轉換率不升反降;或者覺得優惠力度加碼就能衝高訂單,結果毛利被吃掉一大塊。這些決策如果只靠直覺,就永遠分不清是版本問題、季節因素,還是廣告流量品質變了。
A/B測試(又稱split test、版本測試或分流測試)的做法,是把想要比較的兩個版本——例如現行版本A與新版本B——同時分給「大致相同」的一群訪客,讓兩邊各自累積別的變數都一樣的真實流量,最後比較成交率、下單數或點擊率等關鍵指標。因為兩組唯一的不同只有你最想驗證的那個變因,差別自然算得出來。這讓「好不好」不再是個人喜好,而是訪客用行為投票的結果。
為什麼這篇文章談「用數據決策」?因為當你手上同時有GA4的流量數據、電商後台的訂單數據,卻缺乏「先假設、後驗證」的實驗思維,數據只是報表;唯有把它們串成可重複的檢驗流程,數據才真正變成決策依據。這正是一般電商與成熟品牌在優化階段的關鍵分野。若你還沒建立GA4的資料蒐集基礎,可先參考我們整理的GA4電商數據分析入門,把漏斗與事件追蹤先架好,再做實驗才不會測得一頭霧水。
二、A/B測試前先想清楚的四件事
很多人一聽到A/B測試就急著去換文案,步驟卻完全反了。動手之前,先把四個前提想清楚,實驗才不會測了半天得到無意義的答案。
第一件事:你今天的目標指標是什麼? 測試錢、測試圖、測試文案,最終都指向同一個「北極星指標」——多數電商是轉換率(訪客變成訂單的比例)或平均客單價。要先鎖定要改善哪個數字,例如「把商品頁轉換率從1.8%提升到2.2%」,後續的樣本數與時間規劃才有依據。別同時追十個指標,會讓實驗失去焦點。
第二件事:樣本數夠不夠? 這是最容易被忽略、卻最致命的環節。轉換率的改善幅度越小,需要的訪客人數就越多。若想驗證「轉換率從2%提升到2.4%(提升20%)這樣的中等效果」,粗估需要幾千名訪客才能得出可信結論;若只想測0.1% 的微小差異,可能得跑到數萬人。流量太小的店,硬測小變動只會得到「看起來有差、統計上卻無法證明有差」的窘境。計算範例:假設頁面每天只有500名訪客、轉換率2%,要在統計檢定力足夠下分辨2%與2.5%,單組可能就要跑數週才有機會達標——所以在開跑前,先確認你拿得出夠「久」的時間。
第三件事:你只改了一個變因嗎? 同時改文案又改主圖,就算結果變好,你也無法知道功勞屬於誰、下次該複製哪一招。A/B測試的精神就是單一變因:這一輪只改文案,下一輪再單獨測主圖。想一次驗證多個因素,那是A/B/n或多變量測試的領域,難度與樣本需求都會跳級,新手先從單變因開始最穩。
第四件事:測試期間的流量會「乾淨」嗎? 大型促銷、站內改版、廣告預算異動,都會干擾實驗結果。最好避開大促高峰(如雙11、年中慶)與站內大改版期間執行,並確保流量分配是「隨機且固定」的——用分流工具(如VWO、Optimizely、ABtasty、Convert,或Shopify內建的A/B測試應用)做到公平分流,而不是自己手動用日期切分(例如「這週給A版、下週給B版」),那種做法混入了時間偏誤,不是嚴謹的A/B測試。
把四件事的關聯整理成下面的自檢表,開跑前逐項打勾:
| 前置檢查項目 | 檢查重點 | 還沒準備好會怎樣 |
|---|---|---|
| 目標指標 | 是否只鎖定一個重要指標 | 多指標並行會讓勝負失焦 |
| 樣本數估算 | 依改善幅度與現有流量粗估人數與天數 | 樣本不足會得到無統計意義的結果 |
| 單一變因 | 是否一次只改一個元素 | 分不出功勞歸屬、無法複製成功 |
| 流量乾淨度 | 是否避開大促且用工具公平隨機分流 | 時間偏誤與干擾讓數據失真 |
三、設計嚴謹A/B測試的5個步驟
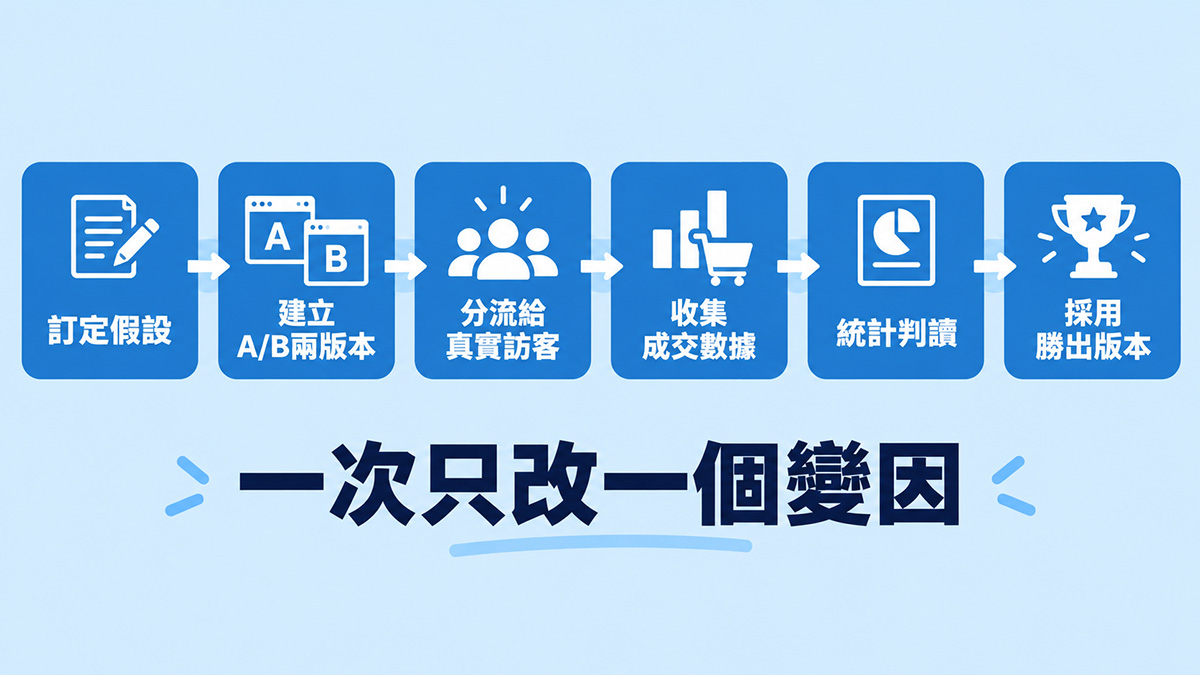
確認前置條件後,就可以按下面的流程把一場實驗完整跑完。這5個步驟適用於商品頁文案、主圖、價格,甚至是廣告素材,是一套通用的實驗框架。
上述流程若需要工具輔助,很多電商平台本身就有內建的實驗功能:例如Shopify的「A/B testing app」能用於主題測試、Meta廣告管理員的「A/B測試(平行測試)」用於素材與受眾比較,Google廣告與GA4也提供實驗功能。第三方工具如Optimizely、VWO、ABtasty則適合較複雜的頁面測試。工具沒有絕對好壞,重點是能達成「隨機分流+單一變因+足夠樣本」三項基本條件。
四、三個最值得測的項目:文案、圖片與價格
新手常不知從何測起。以下三個項目是電商商品頁上最值得優先投入的A/B測試區塊,也是我們內部輔導客戶時最常建議先做的順序。
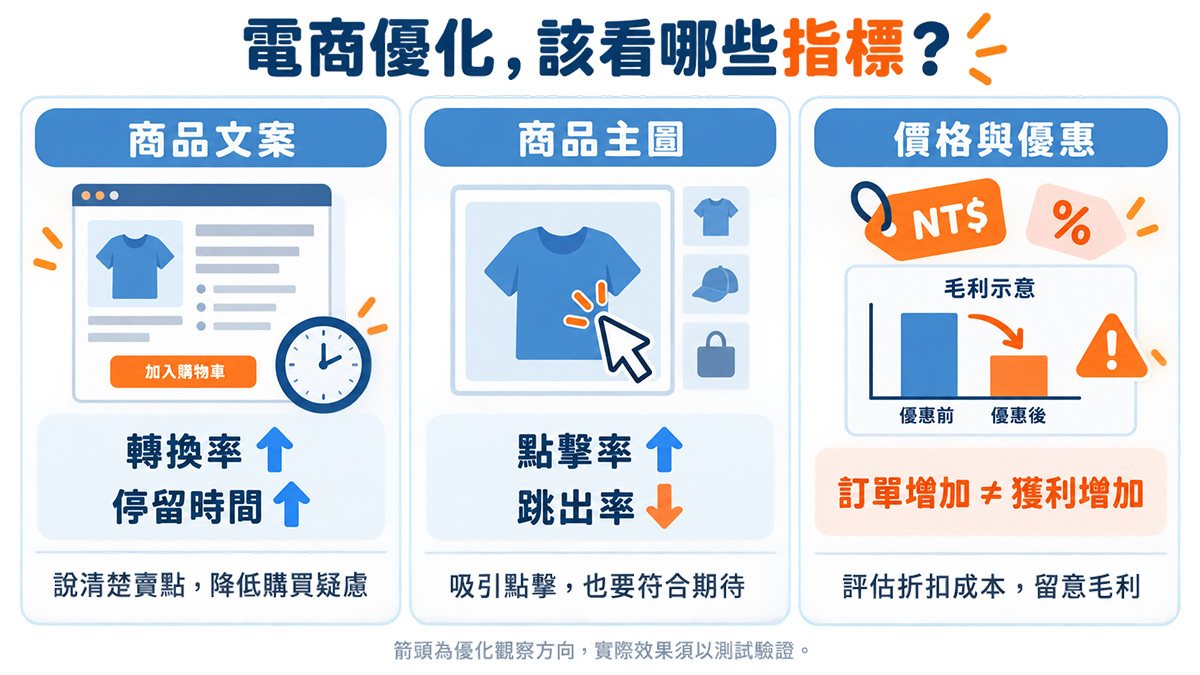
商品文案測試。 文案的測試單位可以是一句副標、一段賣點描述,也可以是整個第一屏的訊息架構。常見做法是各測一種「訴求角度」:例如A版主打「高效省時」,B版主打「口碑信任」,看哪種說法更能促使下單。測文案時,圖片、價格、按鈕都保持不變,才能乾淨歸因。也可以把「長文案 vs 短文案」「功能導向 vs 情感導向」當成對照組合。
商品主圖與頁面圖片測試。 主圖是訪客進到商品頁後「第一眼」的訊號,影響跳出與停留。可比較的變數包括:白底商品圖 vs 情境使用圖、照片 vs 插畫風格、人像 vs 純商品、是否標註促銷貼片。要注意的是,主圖測試最好在流量足夠的品項上做——小眾冷門商品流量太少,測出來的數字容易失真。
價格與優惠呈現測試。 價格測試牽涉毛利,風險最高,一定要算清每版對毛利與客單的影響。可測的變數包括:尾數定價(如 399 vs 400)、原價與特價並陳的呈現方式、是否標「限時」、免運門檻的設定(例如滿999免運 vs 滿499免運)。測價格時要特別小心「售價不同但只測點擊、沒測到毛利差異」的盲點——勝出的版本未必是賺最多的版本。
三個項目的特性差異,用下表一次比較:
| 測試項目 | 主要觀察指標 | 風險與注意 | 適合的店型 |
|---|---|---|---|
| 商品文案 | 轉換率、停留時間、加購率 | 歸因最乾淨、風險低 | 流量穩定的大小賣家皆可 |
| 商品主圖 | 點擊率、跳出率、轉換率 | 需足夠流量、避免貼片混淆 | 有一定流量門檻的品項 |
| 價格與優惠 | 轉換率、客單價、毛利 | 牽動毛利、需算清損益 | 有一定訪客數與毛利空間者 |
實務提醒。 想要縮短實驗週期,可以先從「效果較大、樣本需求較小」的項目開始,例如描述的第一屏改寫,往往比測0.5%的細微價格差異更快得到結論。若你同時想優化多個面向,可諮詢專業的電商策略諮詢服務,由操盤手幫你排出測試優先序,避免在低價值的變因上浪費寶貴流量。
五、判讀A/B測試結果:統計顯著性、p值與信賴區間
實驗跑完,數據在眼前,關鍵是你能不能正確判讀——這往往比設計實驗更考驗功力。
統計顯著性(statistical significance)。 它回答的問題是:「兩版轉換率的差距,是『真』的差異,還是只是隨機波動的結果?」當差異大到不像是碰巧發生,我們就說結果「顯著」。這是判斷「要不要真的採納勝出版本」的科學依據,而不是只看數字高低。
p值(p-value)。 在常態使用的頻率派統計裡,p值代表「假設兩版其實沒差,卻觀察到眼前這種差距(或更大)的機率」。實務上常以p < 0.05作為「顯著」的門檻,意思是:若兩版真的沒差,出現這種極端結果的機率不到5%。p越低,證據越強。但要提醒的是,p值不是「B版贏A版的機率」,也不代表效果大小,它只是「誤判的風險」。
信賴區間(confidence interval,又稱 CI)。 與其只看一個點估計(例如「B版轉換率2.3%」),更穩健的是看「信賴區間」——例如95%信賴區間為2.1%–2.6%,代表以同樣流程重複實驗多次,真值落在這個範圍內的機率約為95%。若B版的信賴區間完全高於A版、兩者不重疊,判斷勝出才有更扎實的底氣。
實務判讀三步驟:
- ✓先確認樣本數已達預估門檻,兩個版本都累積了足夠流量。
- ✓再看p值是否小於0.05(或你用工具設定好的顯著水準)且勝出版本的信賴區間與敗方不重疊。
- ✓最後評估「實務顯著性」——統計顯著卻只多0.1%轉換率,可能不值得承擔改版的營運風險。
記住一句話:統計顯著 ≠ 實務值得。一個「贏了但是在誤差邊緣、且提升幅度微小」的版本,與其急著上線,不如再測一輪或換個更有潛力的變因。
若你對統計判讀沒有把握,許多成熟工具會自動計算p值與信賴區間並標示勝負,降低門檻;但看懂背後意義,才不會被工具的「建議」牽著鼻子走。
六、電商A/B測試常見的6個陷阱
即使流程熟了,實戰仍有六個常踩的坑,先看先避。
誤區一:樣本還沒跑夠就急著看結果。 很多人看到領先10%就立刻喊「B版贏了!」——但在樣本不足時,早期的領先往往只是雜訊,就像丟硬幣連五次正面不代表硬幣有問題。正確做法是事先設定最少樣本與最少天數,期間忍住不看、跑完再判勝負。
誤區二:同時改很多東西。 文案、圖片、價格一次全換,贏了你也不知道贏在哪。正確做法是一次只測一個變因,不同元素分輪次測試,讓每次的結論都可歸因、可複製。
誤區三:把「看到顯著」當成「保證賺錢」。 統計顯著只證明差異不是碰巧,不代表勝出版本一定更好賣或更賺錢。正確做法是額外核對客單價與毛利,尤其價格測試時,別讓「較高的轉換率」掩蓋「較低的毛利」。
誤區四:用日期或流量來源分段代替公平分流。 「這週跑A版、下週跑B版」或「手機看A、桌機看B」,混入了時間與裝置的偏誤。正確做法是用工具對每位訪客隨機分派,並確保同一訪客全程只看同一版。
誤區五:忽略外部干擾。 大促、社群貼文爆紅、競品降價,都會在同一個實驗期內扭曲結果。正確做法是避開大型促銷與站內改版期執測,若無法避開,就把干擾事件記下,判讀時納入考量。
誤區六:勝出後不追蹤、立刻又改。 確認勝出後,若立刻又動第二個變因,等於同時改了兩件事,你無法知道是誰的功勞。正確做法是讓勝出版本穩定一段完整週期,確認沒有副作用後,再規劃下一輪單一變因測試。
這些陷阱其實都源於同一個思維:把A/B測試當成「跑一次拿答案」,而不是「持續累積可信證據的流程」。
七、自己跑A/B測試還是委外?驗收成效的判斷標準
當你規模還小、商品頁不多時,自己架分流工具、自己判讀數字,成本最低、也最能累積語感。但當品項上百、廣告通路跨多平台、或你連基本GA4追蹤都還沒打通時,自己埋頭硬跑反而會拖慢決策。要不要委外的分界,可以看三點:有沒有足夠流量撐起有統計意義的測試、有沒有時間每天盯判讀、以及改版後的數據有沒有系統性地回饋到下一次決策。
如果決定自己跑,記得先確認分流工具與統計判讀都有基本掌握;如果決定交給專業,則要用數據驗收成果,而不是只看對方「建議了很多測試」。合理的委外合作,會先幫你把GA4與實驗追蹤架好、排出測試優先序,再用「轉換率是否如期提升」與「統計是否達顯著」當成驗收依據。
關於如何判斷一門服務是否值得投資,我們先前整理過完整的方法論,可參考GA4漏斗之後的CRO優化指南,把「優化方向與驗收框架」建立起來,無論自跑或委外都適用。
對多通路經營、人力有限的賣家,把系統化優化外包給專業團隊,通常比自己硬撐更划算。你可以先檢視自己最常「憑感覺」改動的是哪個頁面或廣告素材,把該項目當成第一場實驗的切入點。
八、常見問題
Q1:A/B測試要跑多久才準? 沒有一刀切的天數。需以「樣本數+流量速度」估算:樣本越多、日流量越小,就跑越久。實務上中小店家常見單場跑1–3週;流量很小時,把可接受的改善幅度放大(改測較大的變因),能有效縮短時間。
Q2:p值要多少才代表贏? 常用門檻是p < 0.05(誤判風險低於5%)。但p值只反映「差異是否像碰巧」,還需搭配信賴區間與實務效益(客單、毛利)一起看,才算完整的勝負判斷。
Q3:沒有大流量,還適合做A/B測試嗎? 可以,但要「降維」:改測效果較大的變因、把實驗項目聚焦在主力品項上,並接受更長的實驗週期。流量不到一定規模時,硬測微小差異反而浪費時間,不如先優化廣告投放與頁面基礎體驗。
Q4:商品頁主圖可以同時測圖又測文案嗎? 建議不要。同時改兩個元素,你分不出功勞歸屬。正確做法是分輪次單測:先測主圖,確立後再測文案;若確有需要同時驗證多因,屬於A/B/n或多變量測試,樣本需求與複雜度都會大幅提高。
Q5:測試結果「不顯著」代表這次白做了嗎? 不是。「沒有顯著差異」本身就是一個有價值的結論:它告訴你這個變因不值得繼續投入,可以省下資源轉往別處。科學實驗的價值不只在「證明有效」,也在於「排除低效」。
Q6:價格測試會不會傷毛利? 會,所以要做足功課。開測前先算好每一版的毛利與客單變化,設定「最低可接受毛利」當成停損線;測試期間價格不要同時在多個地方大幅浮動,避免干擾歸因。勝出版本必須同時考量轉換率與毛利,而非只看哪版賣得多。
A/B測試不是一門花俏的技術,而是把「猜測」換成「驗證」的習慣。先從一個你最有疑問的商品頁欄位開始,按本文5個步驟跑完第一場實驗——勝出固然開心,但就算不顯著,你也學到了「這個變因不值得再試」的明確答案。有了這個習慣,你的每次改版都會開始累積數據複利,而不是單純的勞累。